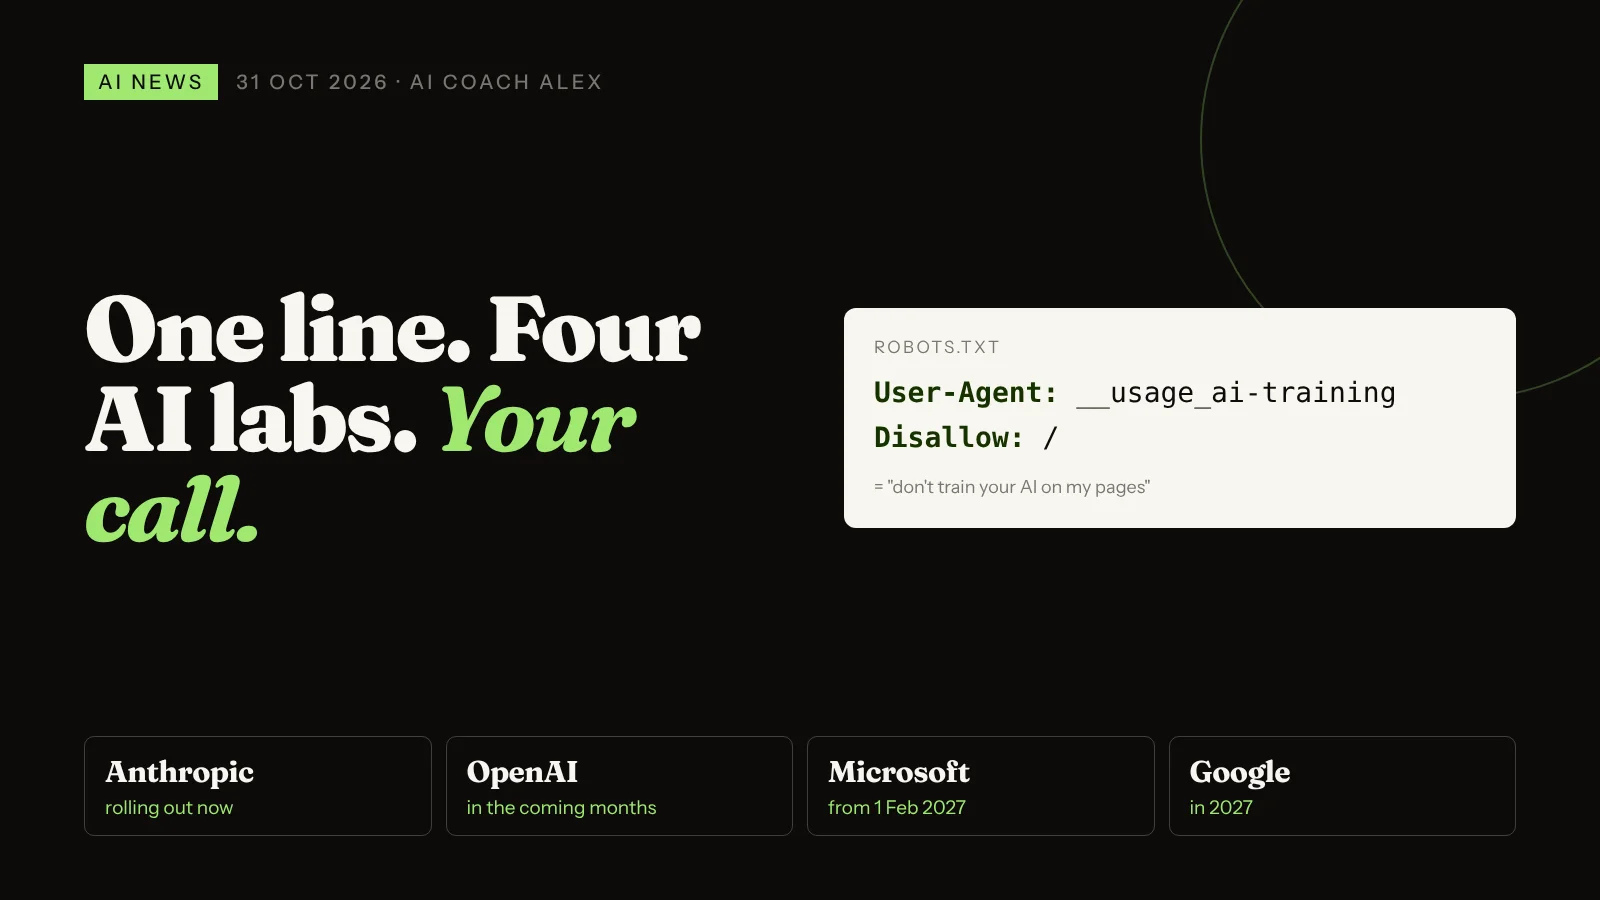
Ya existe una forma común de pedir a los grandes laboratorios de IA que no entrenen con tu web. El 30 de octubre, OpenAI, Google, Microsoft y Anthropic anunciaron que respetarán un nuevo token de robots.txt, __usage_ai-training, propuesto en un borrador del IETF por Kevin Kelley, de Anthropic. Anthropic ya ha empezado a aplicarlo, OpenAI dice que en los próximos meses, Microsoft desde el 1 de febrero de 2027 y Google en 2027. Solo cubre el entrenamiento: no impide que los bots visiten tu web, no borra lo que ya se ha recopilado y no afecta a tu posición en Google o Bing. Para la mayoría de pequeñas empresas que quieren que las encuentren, lo inteligente es decidir a propósito, no bloquearlo todo.
Cada pocas semanas un cliente me pregunta alguna versión de "¿la IA me está robando la web?". La respuesta honesta era un lío: cada empresa de IA tenía su propio rastreador, sus propias reglas y su propia letra pequeña. Bloquearlos significaba mantener una lista, y nunca sabías si te faltaba alguno.
Ayer eso se simplificó. No se resolvió, pero se simplificó. Y obliga a hacerse una pregunta que pocos dueños de negocio se han planteado: ¿de verdad quieres que la IA deje de aprender de ti?
¿Qué es el nuevo token para excluir tu web del entrenamiento de IA?
Según el resumen de AI Weekly sobre la noticia de The Verge, las cuatro empresas apoyan una única señal para los editores web. Procede de un borrador de Internet llamado "Machine-Readable Training Preference Signal", escrito por Kevin Kelley, responsable de estándares de Anthropic, y fechado el 30 de octubre. Es un borrador individual, así que aún no tiene rango formal en el IETF, pero los cuatro grandes laboratorios han dicho que lo seguirán.
En la práctica son dos líneas en el archivo robots.txt que ya está en la raíz de tu web:
| Pregunta | La respuesta | En cristiano |
|---|---|---|
| ¿Qué añado? | User-Agent: __usage_ai-training y después Disallow: / | "No uses ninguna de mis páginas para entrenar IA" |
| ¿Puedo permitir algunas páginas? | Sí, con líneas Allow:, como cualquier regla de robots.txt | Bloquea el blog y deja abierta la página de servicios, o al revés |
¿Lo cubre User-agent: *? | No. El borrador deja el comodín fuera a propósito | Tienes que añadir la línea con su nombre |
| ¿Quién lo respetará? | Anthropic (ya empezó), OpenAI (próximos meses), Microsoft (1 feb 2027), Google (2027) | No todos a la vez, ni todavía en todas partes |
| ¿Y las reglas antiguas? | Las reglas por bot, como Google-Extended, siguen funcionando. Google tratará el nuevo token como un bloqueo de Google-Extended si no tienes una regla aparte | Nada de lo que configuraste antes se rompe |
| ¿Quién falta? | Meta dijo que una señal común es "un paso importante", pero no se ha comprometido a respetarla | No todas las empresas de IA están dentro |
Según AI Weekly, en el borrador participaron organizaciones como Cloudflare, News Corp, el Financial Times, la BBC, la EFF, Creative Commons y Common Crawl. Un resumen en DEV de la cobertura de SiliconANGLE confirma el mismo token y los mismos plazos.
¿Bloquear el entrenamiento de IA saca mi web de ChatGPT o de Google?
No, y aquí es donde la mayoría se va a equivocar. El token trata del entrenamiento: lo que entra en el próximo modelo. No trata de la consulta: la IA visitando tu página hoy para responder a la pregunta de alguien.
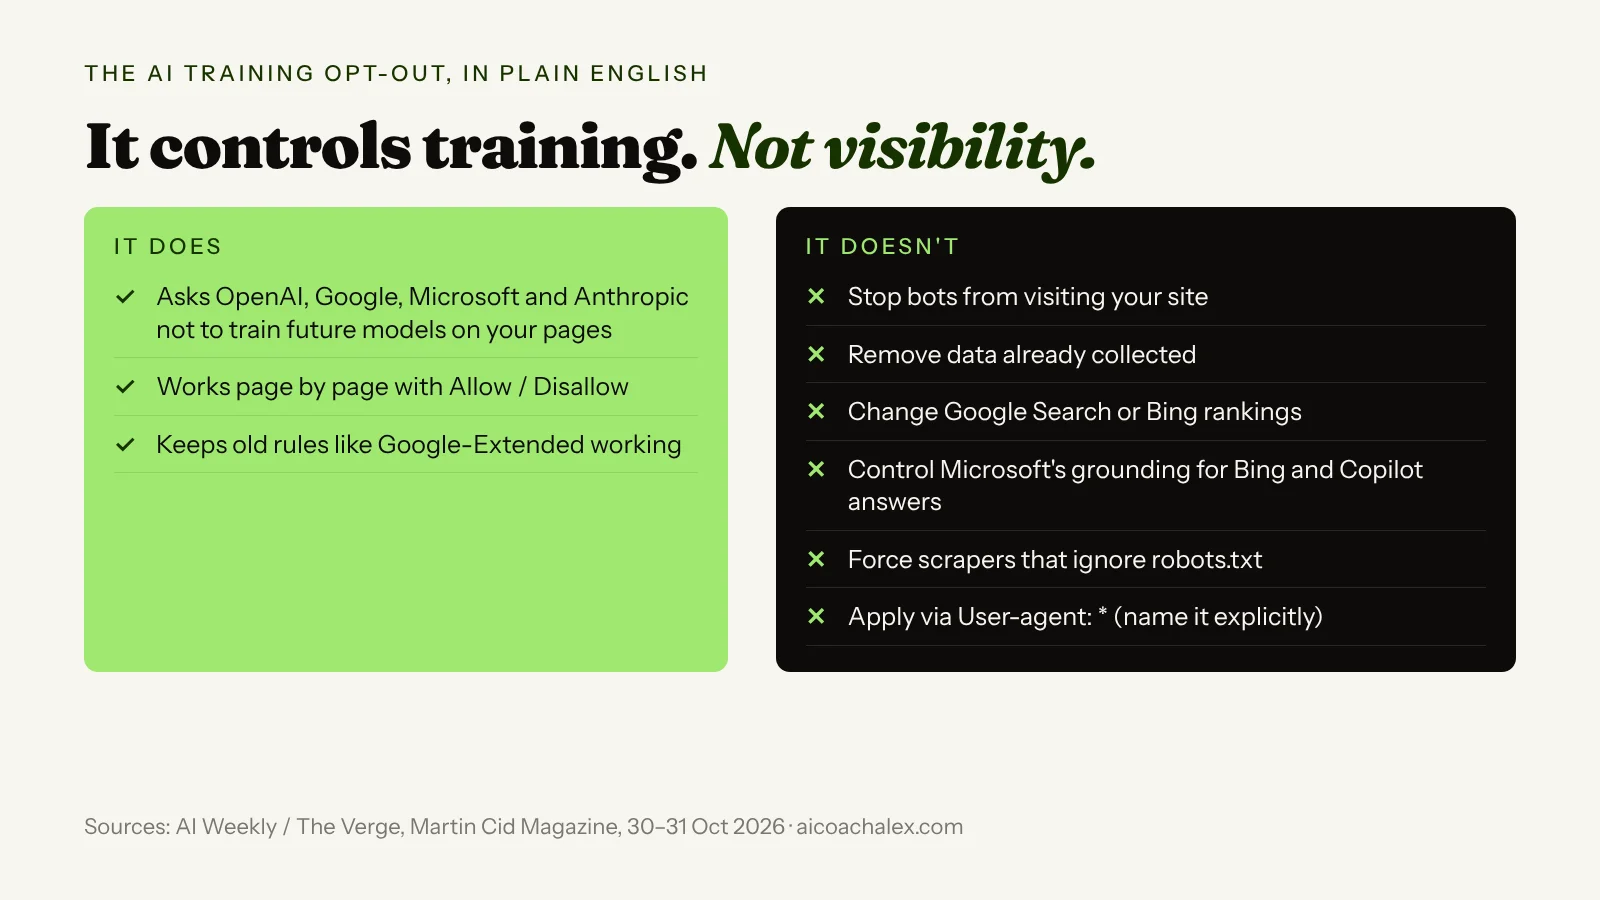
- La búsqueda no cambia. Según el análisis de Martin Cid Magazine, Google dice que Google-Extended no afecta a la Búsqueda de Google, y Microsoft dice que sus ajustes no cambian si apareces en Bing.
- Las respuestas de IA van aparte. Microsoft tiene una preferencia distinta de "grounding", que se configura página a página con una etiqueta meta o una cabecera HTTP, para el contenido que su IA usa al responder en Bing, Copilot y Microsoft 365. Microsoft avisa de que decir que no ahí reduce mucho tu visibilidad en esas respuestas.
- El pasado se queda dentro. Cambiar el robots.txt no elimina el contenido ya recopilado en conjuntos de datos o modelos entrenados. Solo mira hacia delante.
- Es una petición, no un candado. OpenAI describe el token como "un mecanismo de coordinación, no un control de seguridad". Los rastreadores educados lo siguen. Los malos, no.
¿Por qué te importa?
Para una pequeña empresa, la pregunta real no es "¿puedo frenar a la IA?". Es "¿qué quiero que la IA sepa de mí?".
Si alguien pregunta a ChatGPT, Claude o Gemini "¿un buen gestor en Valencia?" o "mejor coach de IA para pymes", los modelos responden con lo que aprendieron en el entrenamiento y con las páginas que consultan en directo. Un negocio que bloquea el entrenamiento hoy puede acabar siendo menos conocido por la próxima generación de modelos. Es un intercambio real, y hablé del contexto general en tu próximo cliente no mirará tu web, la leerá (en inglés).
Por otro lado, si tu producto es tu contenido (cursos, fotografía, newsletters de pago, recetas, plantillas), que entrenen con él gratis es otra historia. Para ti, este token es la primera exclusión que funciona con los cuatro grandes laboratorios con una sola línea.
Mi regla general:
- Vendes un servicio y quieres que te encuentren: deja el entrenamiento abierto en tus páginas comerciales públicas. Que la IA te conozca es marketing gratis.
- Vendes contenido: bloquea el entrenamiento en las partes de pago o premium y deja abiertas las páginas de venta y el "sobre mí".
- En ambos casos: no bloquees por accidente los rastreadores de búsqueda ni las respuestas de IA intentando bloquear el entrenamiento.
¿Cómo configurar en robots.txt si la IA puede entrenar con tu web?
- Mira lo que tienes ahora. Escribe
tudominio.com/robots.txten el navegador. Apunta cualquier línea que mencione GPTBot, ClaudeBot, Google-Extended oUser-agent: *conDisallow: /. Algunos creadores de webs y plugins de seguridad añadieron bloqueos de IA sin avisarte. - Decide página a página, no para toda la web. Haz dos listas: páginas que quieres que la IA conozca (inicio, servicios, sobre mí, precios, preguntas frecuentes, blog) y páginas que prefieres dejar fuera del entrenamiento (contenido de pago, áreas de clientes, descargas).
- Añade el nuevo grupo solo si la segunda lista no está vacía. Usa
User-Agent: __usage_ai-trainingy luego una líneaDisallow:por cada carpeta que quieras excluir, oDisallow: /para todo. Recuerda que el grupo comodín no cuenta. - Mantén tus reglas antiguas. No borres las líneas por bot durante la transición. Google y Microsoft no seguirán el nuevo token hasta 2027.
- Comprueba que nada bloquea la búsqueda. Asegúrate de que no hay un
Disallow: /general bajoUser-agent: *, salvo que de verdad quieras desaparecer de los buscadores. - Pon dos recordatorios. El 1 de febrero de 2027 (Microsoft empieza a respetar el token) y principios de 2027 para revisar los avances de Google. Si usas Wix, Squarespace, Shopify o WordPress y no puedes editar el robots.txt directamente, pregunta a quien gestione tu web.
Copia este prompt: tu política de entrenamiento de IA en 10 minutos
Pégalo en ChatGPT, Claude o Gemini junto con tu robots.txt actual. Te ayuda a decidir y te escribe las líneas. Revisa el resultado antes de publicarlo: una línea Disallow equivocada puede esconder tu web de los buscadores.
Eres un asesor web prudente para una pequeña empresa.
Ayúdame a decidir qué partes de mi web pueden usar las
empresas de IA para entrenar sus modelos y escribe las
líneas de robots.txt.

MI NEGOCIO: [p. ej. clínica de fisioterapia, creadora de cursos online]
CÓMO ME ENCUENTRAN LOS CLIENTES: [p. ej. Google, Instagram, recomendaciones, ChatGPT]
QUÉ VENDO: [servicio / contenido / productos]
SECCIONES DE MI WEB: [p. ej. /servicios, /blog, /cursos, /socios]
MI ROBOTS.TXT ACTUAL:
[pégalo aquí]

Contexto: OpenAI, Google, Microsoft y Anthropic respetarán
un grupo común de robots.txt "User-Agent: __usage_ai-training"
que solo cubre el entrenamiento de IA. No afecta a la búsqueda,
no impide el rastreo y "User-agent: *" no lo cubre.

Después:
1. Hazme hasta 5 preguntas si algo no está claro.
2. Recomiéndame qué secciones dejar abiertas al entrenamiento
   de IA y cuáles bloquear, con una frase de motivo para cada una.
3. Señala cualquier línea actual que pueda estar escondiendo
   mi web de los buscadores o de las respuestas de IA por error.
4. Escribe el robots.txt actualizado completo, manteniendo
   mis reglas antiguas.
5. Enumera, en lenguaje sencillo, lo que esto NO protege.

Marca como suposición todo lo que no tengas claro.
Un robots.txt que nadie ha leído desde que se lanzó la web. Un plugin de seguridad que bloquea en silencio algunos bots de IA y se deja otros. Ni idea de si las herramientas de IA pueden ver tu página de servicios.
Una política decidida: páginas comerciales abiertas para que la IA pueda recomendarte, contenido de pago fuera del entrenamiento con una sola línea común, la búsqueda intacta y un recordatorio para revisarlo en 2027.
¿Quieres que la IA recomiende tu negocio en vez de ignorarlo?
En una llamada de diagnóstico de 49 € vemos cómo te ven hoy ChatGPT, Claude y Gemini, revisamos qué les deja leer tu web y elegimos los primeros arreglos para que te encuentren.
Reservar diagnóstico de 49 € →También hoy en IA
Comcast recorta empleos de call center mientras los agentes de IA toman el relevo
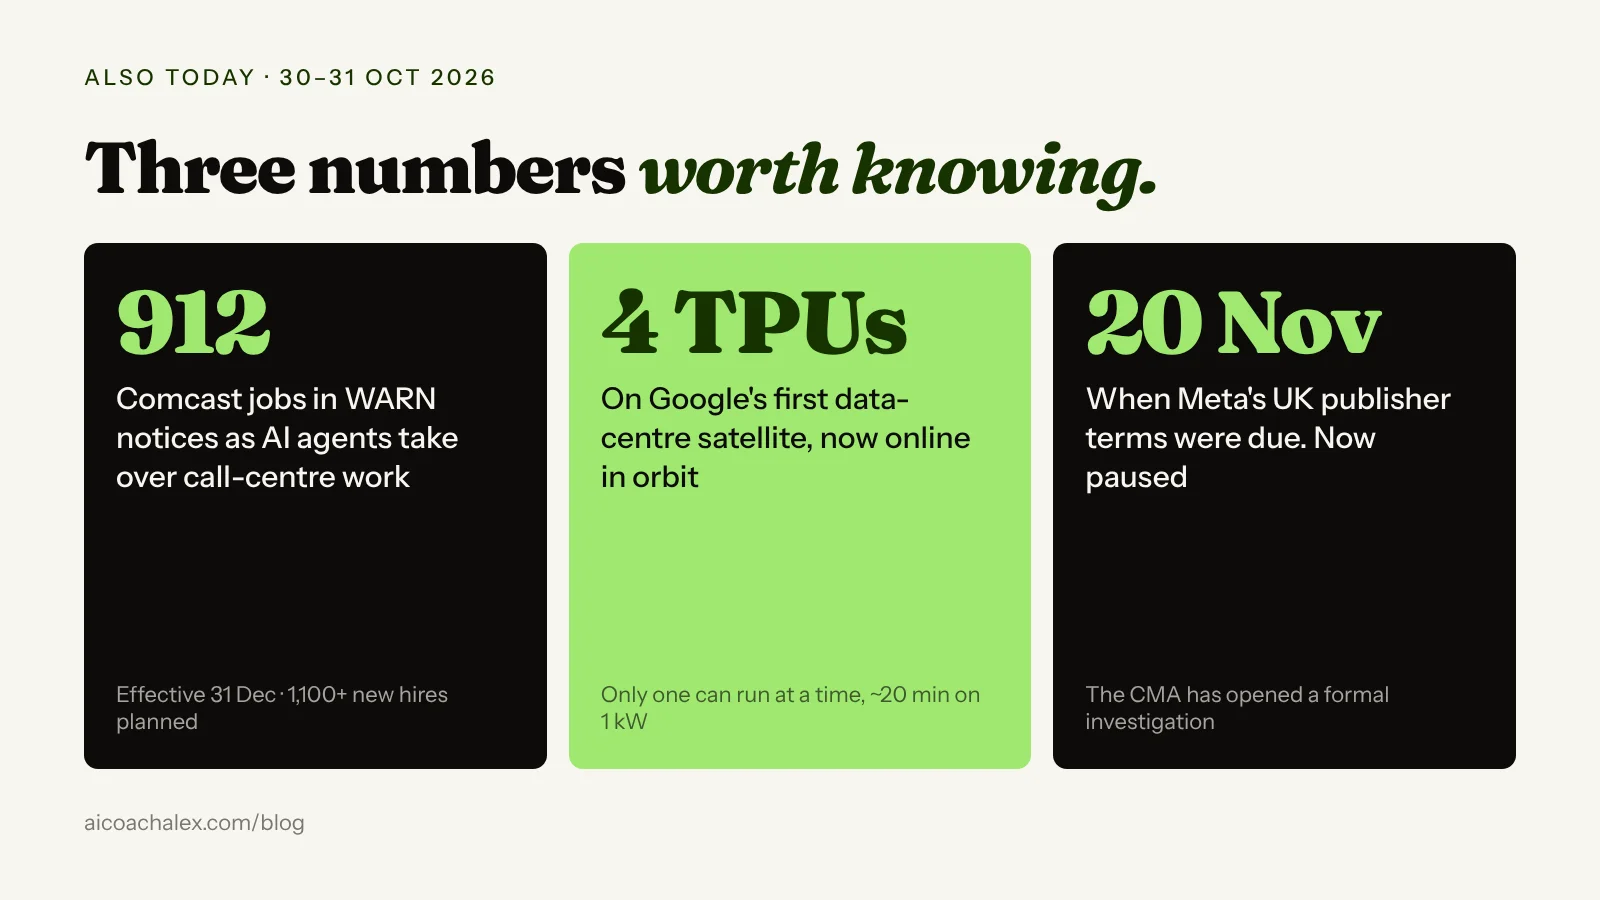
Comcast presentó avisos WARN por 912 empleos (634 en Filadelfia, 119 en Nueva Jersey y 159 en el estado de Washington), efectivos el 31 de diciembre, mientras planea más de 1.100 nuevas contrataciones, según AI Weekly. GadgetReview informa de que Comcast, que perdió 144.000 clientes de banda ancha el último trimestre, trabaja con las empresas de atención al cliente con IA Cresta y Sierra, y de que los agentes de IA han eliminado más de 30 millones de interacciones de servicio este año y reducido los contactos en torno a un 20 %.
Qué significa para ti: si un gigante puede pasar una quinta parte de sus contactos con clientes a la IA, una pequeña empresa puede empezar por sus diez preguntas más repetidas. Escribe las respuestas una vez, ponlas en tu web y en un asistente, y deja a una persona para los casos difíciles. Mi artículo sobre las empresas que vuelven a contratar a quienes sustituyó la IA (en inglés) cuenta qué sale mal cuando recortas personas primero.
El primer satélite centro de datos de Google ya está operativo
Google dice que su prototipo de Project Suncatcher, lanzado en un Falcon 9 de SpaceX el 1 de octubre, ya está operativo, y que su primera prueba fue Gemma 4 escribiendo un haiku desde la órbita, según AI Weekly. El satélite lleva cuatro TPU, pero solo puede alimentar una a la vez, durante unos 20 minutos con un presupuesto de 1 kW. NewsBytes explica que está probando si los chips aguantan la radiación y las temperaturas extremas. Hay otros dos satélites con chips más nuevos previstos para 2027.
Qué significa para ti: nada que hacer hoy. Es una señal de lo mucho que buscan las empresas de IA energía y capacidad de cálculo, y por eso los precios y límites de uso de la IA no paran de cambiar. No construyas tu negocio sobre el precio actual de una sola herramienta.
El regulador británico investiga los términos de Meta para editores
La Competition and Markets Authority del Reino Unido abrió el 30 de octubre una investigación formal para ver si los nuevos términos comerciales de Meta, que le permitirían usar el contenido web de editores británicos para sus propios productos y funciones de IA sin darles opción, constituyen un abuso de posición dominante, según AI Weekly. Los cambios de Meta, previstos para el 20 de noviembre, están en pausa.
Qué significa para ti: si haces anuncios o tienes una página de empresa en Facebook o Instagram, lee los términos que aceptas. Expliqué qué suponen los últimos términos de Meta para negocios en Los nuevos términos de Meta te hacen pagar los errores de su IA.
FAQ
¿Qué es __usage_ai-training en robots.txt?
Es un token común de robots.txt que pide a las empresas de IA que no usen tus páginas para entrenar sus modelos. Se añade como grupo propio, "User-Agent: __usage_ai-training" seguido de "Disallow: /" o de carpetas concretas. Procede de un borrador del IETF escrito por Kevin Kelley, de Anthropic, en octubre de 2026.
¿Qué empresas de IA respetan el nuevo token de exclusión?
OpenAI, Google, Microsoft y Anthropic. Anthropic ya ha empezado a aplicarlo, OpenAI dice que en los próximos meses, Microsoft desde el 1 de febrero de 2027 y Google en 2027. Meta ha aplaudido la idea, pero no se ha comprometido a respetarlo.
¿Bloquear el entrenamiento de IA perjudica mi posicionamiento en Google?
No. El token solo cubre el entrenamiento de IA. Google dice que Google-Extended no afecta a la Búsqueda de Google, y Microsoft dice que sus ajustes de entrenamiento no cambian tu presencia en Bing. Eso sí, no añadas un "Disallow: /" general bajo "User-agent: *", que bloquea también a los buscadores.
¿La exclusión impide que ChatGPT o Copilot citen mi web?
Por sí sola, no. Cubre el entrenamiento, no la consulta en directo para responder preguntas. Microsoft tiene una preferencia de grounding aparte, que se configura con una etiqueta meta o una cabecera HTTP, para sus respuestas de IA, y avisa de que excluirse reduce mucho la visibilidad en Bing y Copilot.
¿La exclusión borra el contenido con el que la IA ya se ha entrenado?
No. Solo se aplica a partir de ahora. El contenido ya recopilado en conjuntos de datos o modelos entrenados no se elimina al cambiar el robots.txt.
¿Debería una pequeña empresa bloquear el entrenamiento de IA?
Depende de lo que vendas. Si vendes un servicio y quieres que te recomienden, dejar abiertas tus páginas comerciales públicas suele ayudar. Si tu contenido es el producto, como cursos, fotos o artículos de pago, tiene sentido bloquear el entrenamiento en esas secciones. Decide página a página.
Que la IA te encuentre, con tus condiciones.
Coaching individual para dueños de negocio: decidimos qué debe saber la IA de tu empresa, arreglamos tu web y tus fichas, y configuramos herramientas de IA que te traen clientes.
Reservar diagnóstico de 49 € → IA para dueños de negocioFuentes: AI Weekly: OpenAI, Google, Microsoft, Anthropic back one AI opt-out token (30 oct 2026, resumen de The Verge); Martin Cid Magazine: One robots.txt line will opt your site out of AI training (31 oct 2026); DEV Community, a partir de SiliconANGLE (31 oct 2026); AI Weekly: AI news today (Comcast, Google Suncatcher, CMA y Meta, 30 oct 2026); GadgetReview (Comcast, 26 oct 2026); NewsBytes (Suncatcher). La regla general y los pasos son consejo mío.