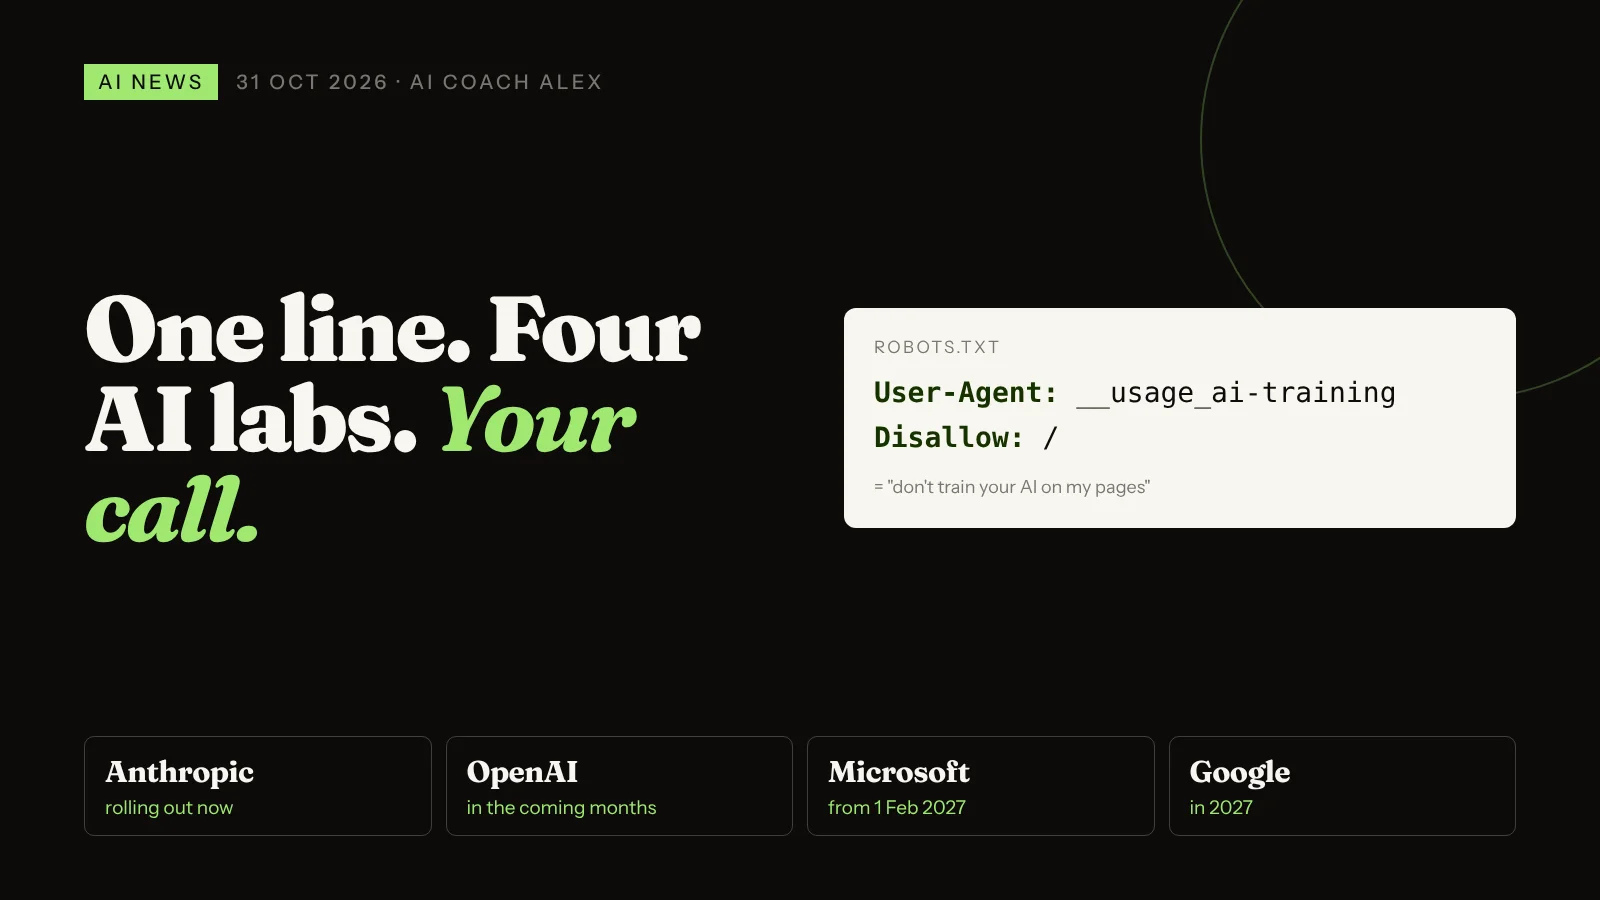
Ora esiste un modo condiviso per chiedere ai grandi laboratori di IA di non addestrarsi sul tuo sito. Il 30 ottobre OpenAI, Google, Microsoft e Anthropic hanno dichiarato che rispetteranno un nuovo token di robots.txt, __usage_ai-training, proposto in una bozza IETF da Kevin Kelley di Anthropic. Anthropic ha iniziato ad applicarlo, OpenAI dice nei prossimi mesi, Microsoft dal 1° febbraio 2027 e Google nel 2027. Copre solo l'addestramento: non impedisce ai bot di visitare il sito, non cancella ciò che è già stato raccolto e non tocca il posizionamento su Google o Bing. Per la maggior parte delle piccole imprese che vogliono essere trovate, la mossa giusta è decidere consapevolmente, non bloccare tutto.
Ogni poche settimane un cliente mi chiede una variante di "l'IA mi sta rubando il sito?". La risposta onesta finora era un groviglio: ogni azienda di IA aveva il suo crawler, le sue regole e le sue clausole in piccolo. Bloccarli voleva dire tenere una lista, senza mai sapere se te ne mancava qualcuno.
Ieri è diventato più semplice. Non risolto, ma più semplice. E costringe a farsi una domanda che pochi imprenditori si sono posti: vuoi davvero che l'IA smetta di imparare da te?
Cos'è il nuovo token per escludere il sito dall'addestramento dell'IA?
Come riporta AI Weekly riassumendo l'articolo di The Verge, le quattro aziende sostengono un unico segnale per chi pubblica online. Nasce da una bozza Internet intitolata "Machine-Readable Training Preference Signal", scritta da Kevin Kelley, responsabile degli standard di Anthropic, e datata 30 ottobre. È una bozza individuale, quindi non ha ancora valore formale all'IETF, ma i quattro grandi laboratori hanno detto che la seguiranno.
In pratica sono due righe nel file robots.txt che si trova già nella radice del tuo sito:
| Domanda | La risposta | In parole semplici |
|---|---|---|
| Cosa aggiungo? | User-Agent: __usage_ai-training e poi Disallow: / | "Non usare nessuna delle mie pagine per addestrare l'IA" |
| Posso consentire alcune pagine? | Sì, con righe Allow:, come qualsiasi regola di robots.txt | Blocca il blog e lascia aperta la pagina servizi, o viceversa |
User-agent: * lo copre? | No. La bozza esclude di proposito il carattere jolly | Devi aggiungere la riga con il suo nome |
| Chi lo rispetterà? | Anthropic (già iniziato), OpenAI (prossimi mesi), Microsoft (1° feb 2027), Google (2027) | Non tutti insieme, e non ancora ovunque |
| E le vecchie regole? | Le regole per singolo bot, come Google-Extended, continuano a funzionare. Google tratterà il nuovo token come un blocco Google-Extended se non hai una regola separata | Niente di ciò che avevi impostato si rompe |
| Chi manca? | Meta ha definito un segnale comune "un passo importante", ma non si è impegnata a rispettarlo | Non tutte le aziende di IA ci sono |
Secondo AI Weekly, alla bozza hanno contribuito organizzazioni come Cloudflare, News Corp, il Financial Times, la BBC, la EFF, Creative Commons e Common Crawl. Un riassunto su DEV della copertura di SiliconANGLE conferma lo stesso token e le stesse tempistiche.
Bloccare l'addestramento dell'IA toglie il mio sito da ChatGPT o da Google?
No, ed è qui che molti sbaglieranno. Il token riguarda l'addestramento: ciò che entra nel prossimo modello. Non riguarda la consultazione: l'IA che visita la tua pagina oggi per rispondere alla domanda di qualcuno.
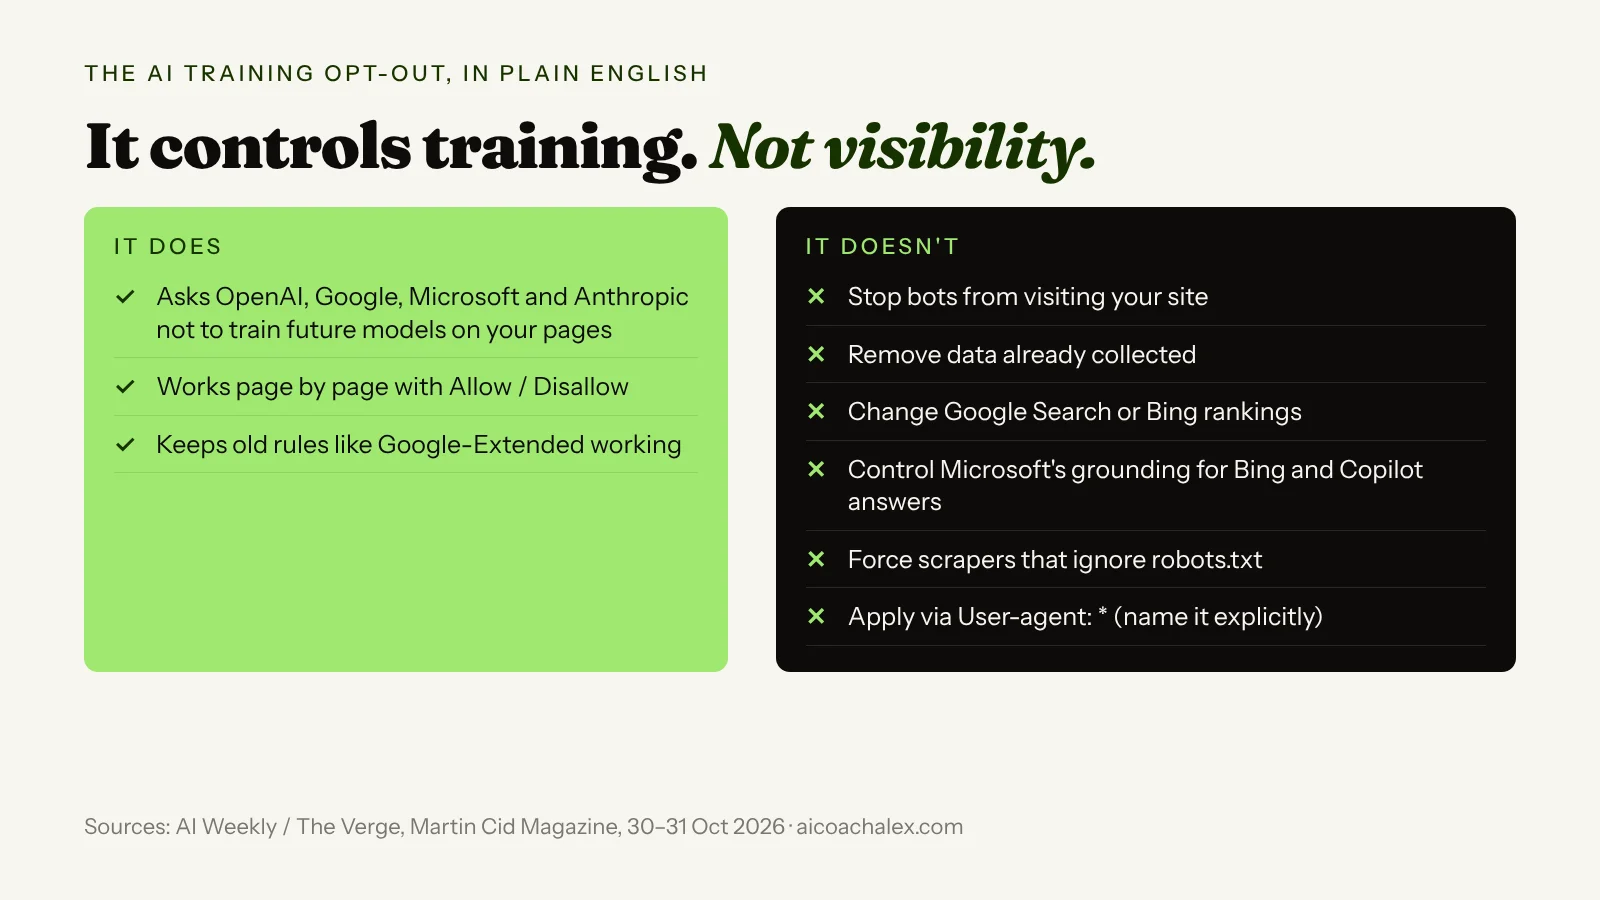
- La ricerca non cambia. Secondo l'analisi di Martin Cid Magazine, Google dice che Google-Extended non influisce sulla Ricerca Google, e Microsoft dice che le sue impostazioni non cambiano la tua presenza su Bing.
- Le risposte dell'IA sono un interruttore a parte. Microsoft ha una preferenza separata di "grounding", impostata pagina per pagina con un meta tag o un'intestazione HTTP, per i contenuti che la sua IA usa per rispondere su Bing, Copilot e Microsoft 365. Microsoft avverte che dire di no lì riduce molto la tua visibilità in quelle risposte.
- Il passato resta dentro. Modificare il robots.txt non rimuove i contenuti già raccolti in dataset o modelli addestrati. Vale solo per il futuro.
- È una richiesta, non un lucchetto. OpenAI descrive il token come "un meccanismo di coordinamento, non un controllo di sicurezza". I crawler corretti lo rispettano. Quelli scorretti no.
Perché ti riguarda?
Per una piccola impresa la vera domanda non è "posso fermare l'IA?". È "cosa voglio che l'IA sappia di me?".
Se qualcuno chiede a ChatGPT, Claude o Gemini "un buon commercialista a Bologna?" o "miglior coach di IA per piccole imprese", i modelli rispondono con ciò che hanno imparato in addestramento e con le pagine che consultano in tempo reale. Un'attività che oggi blocca l'addestramento rischia, col tempo, di essere conosciuta meno dalla prossima generazione di modelli. È un compromesso reale, e ne ho parlato in generale in il tuo prossimo cliente non guarderà il tuo sito, lo leggerà (in inglese).
Dall'altra parte, se il tuo prodotto è il contenuto (corsi, fotografia, newsletter a pagamento, ricette, template), che ci si addestri sopra gratis è un altro discorso. Per te questo token è il primo opt-out che funziona con tutti e quattro i grandi laboratori con una sola riga.
La mia regola pratica:
- Vendi un servizio e vuoi che i clienti ti trovino: lascia aperto l'addestramento sulle pagine commerciali pubbliche. Essere conosciuti dall'IA è marketing gratuito.
- Vendi contenuti: blocca l'addestramento sulle parti a pagamento o premium e lascia aperte le pagine di vendita e il "chi sono".
- In entrambi i casi: non bloccare per sbaglio i crawler di ricerca o le risposte dell'IA mentre cerchi di bloccare l'addestramento.
Come impostare nel robots.txt se l'IA può addestrarsi sul tuo sito
- Guarda cosa hai adesso. Scrivi
tuodominio.it/robots.txtnel browser. Annota le righe che citano GPTBot, ClaudeBot, Google-Extended oUser-agent: *conDisallow: /. Alcuni costruttori di siti e plugin di sicurezza hanno aggiunto blocchi per l'IA senza dirtelo. - Decidi pagina per pagina, non per tutto il sito. Fai due liste: pagine che vuoi far conoscere all'IA (home, servizi, chi sono, prezzi, domande frequenti, blog) e pagine che preferisci tenere fuori dall'addestramento (contenuti a pagamento, aree clienti, download).
- Aggiungi il nuovo gruppo solo se la seconda lista non è vuota. Usa
User-Agent: __usage_ai-training, poi una rigaDisallow:per ogni cartella da escludere, oppureDisallow: /per tutto. Ricorda che il gruppo jolly non conta. - Mantieni le vecchie regole. Non cancellare le righe per singolo bot durante la transizione. Google e Microsoft non seguiranno il nuovo token fino al 2027.
- Verifica che niente blocchi la ricerca. Assicurati che non ci sia un
Disallow: /generale sottoUser-agent: *, a meno che tu non voglia davvero sparire dai motori di ricerca. - Imposta due promemoria. Il 1° febbraio 2027 (Microsoft inizia a rispettare il token) e inizio 2027 per controllare i progressi di Google. Se usi Wix, Squarespace, Shopify o WordPress e non puoi modificare il robots.txt direttamente, chiedi a chi gestisce il tuo sito.
Copia questo prompt: la tua policy sull'addestramento IA in 10 minuti
Incollalo in ChatGPT, Claude o Gemini insieme al tuo robots.txt attuale. Ti aiuta a decidere e scrive le righe al posto tuo. Controlla il risultato prima di pubblicarlo: una riga Disallow sbagliata può nascondere il sito ai motori di ricerca.
Sei un consulente web prudente per una piccola impresa.
Aiutami a decidere quali parti del mio sito le aziende di IA
possono usare per addestrare i loro modelli e scrivi le
righe del robots.txt.

LA MIA ATTIVITÀ: [es. studio di fisioterapia, creatrice di corsi online]
COME MI TROVANO I CLIENTI: [es. Google, Instagram, passaparola, ChatGPT]
COSA VENDO: [servizio / contenuti / prodotti]
SEZIONI DEL MIO SITO: [es. /servizi, /blog, /corsi, /area-soci]
IL MIO ROBOTS.TXT ATTUALE:
[incollalo qui]

Contesto: OpenAI, Google, Microsoft e Anthropic rispetteranno
un gruppo comune di robots.txt "User-Agent: __usage_ai-training"
che copre solo l'addestramento dell'IA. Non influisce sulla
ricerca, non blocca la scansione e "User-agent: *" non lo copre.

Poi:
1. Fammi fino a 5 domande se qualcosa non è chiaro.
2. Consigliami quali sezioni lasciare aperte all'addestramento
   e quali bloccare, con una frase di motivazione per ciascuna.
3. Segnala qualsiasi riga attuale che potrebbe nascondere per
   errore il mio sito ai motori di ricerca o alle risposte IA.
4. Scrivi il robots.txt aggiornato completo, mantenendo le
   mie vecchie regole.
5. Elenca, in parole semplici, cosa tutto questo NON protegge.

Segna come ipotesi tutto ciò di cui non sei sicuro.
Un robots.txt che nessuno legge dal lancio del sito. Un plugin di sicurezza che blocca in silenzio alcuni bot di IA e ne lascia passare altri. Nessuna idea se gli strumenti di IA vedano la tua pagina servizi.
Una policy consapevole: pagine commerciali aperte perché l'IA possa consigliarti, contenuti a pagamento fuori dall'addestramento con una sola riga comune, ricerca intatta e un promemoria per ricontrollare nel 2027.
Vuoi che l'IA consigli la tua attività invece di ignorarla?
In una call di diagnosi da 49 € vediamo come ti vedono oggi ChatGPT, Claude e Gemini, controlliamo cosa lascia leggere il tuo sito e scegliamo le prime correzioni per farti trovare.
Prenota la diagnosi da 49 € →Anche oggi nell'IA
Comcast taglia posti nei call center mentre arrivano gli agenti IA
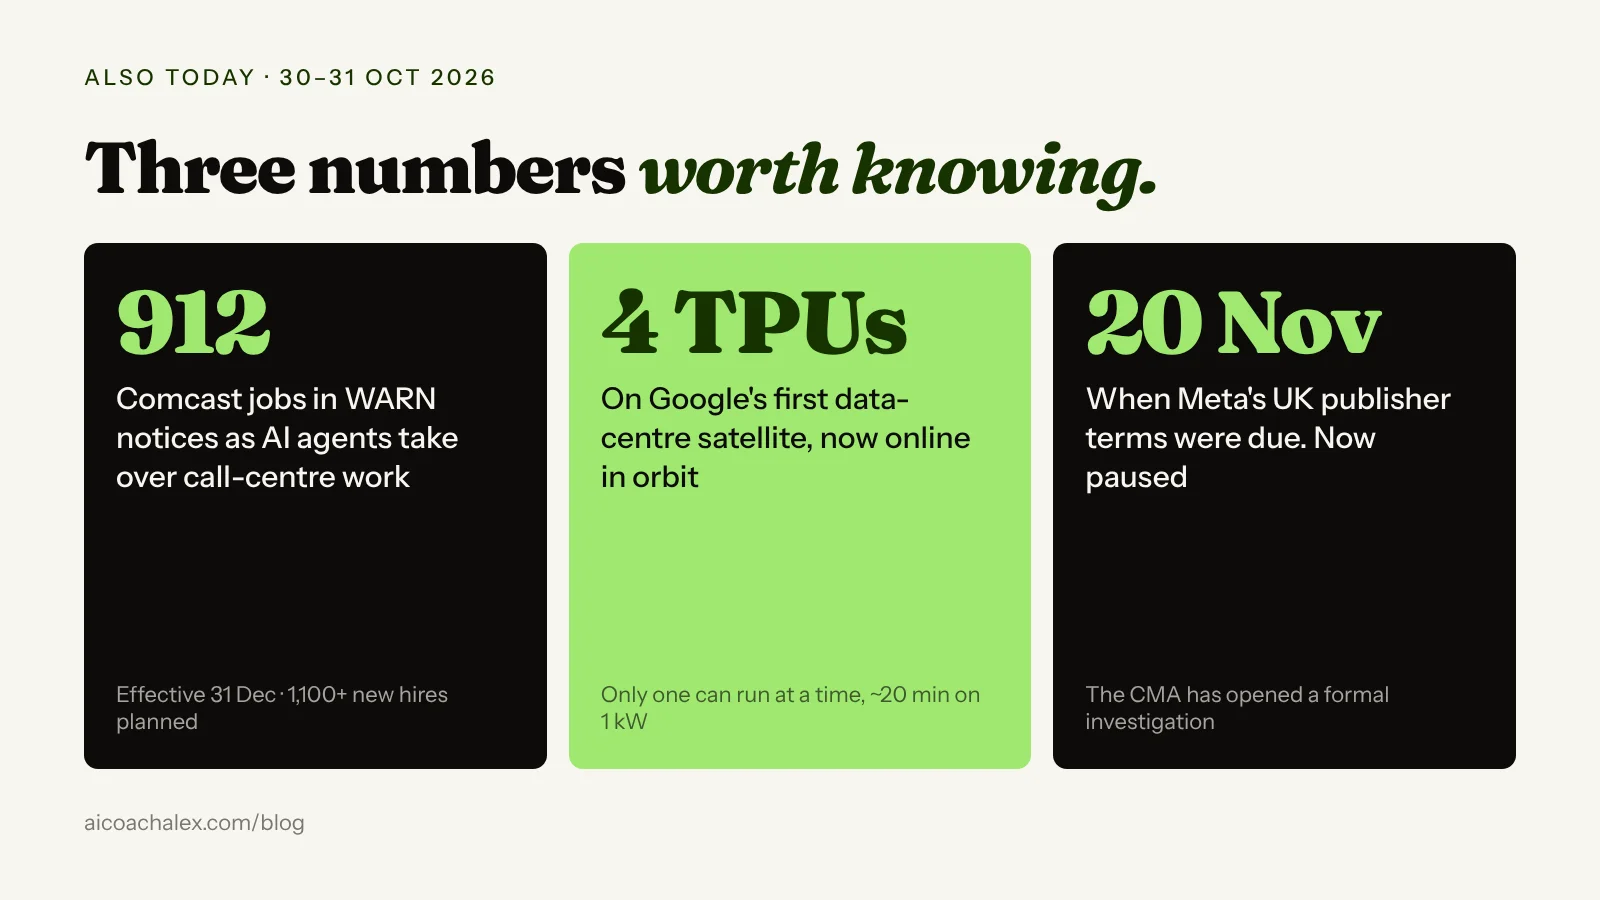
Comcast ha presentato avvisi WARN per 912 posti di lavoro (634 a Filadelfia, 119 nel New Jersey e 159 nello stato di Washington), con effetto dal 31 dicembre, mentre pianifica oltre 1.100 nuove assunzioni, secondo AI Weekly. GadgetReview riporta che Comcast, che ha perso 144.000 clienti della banda larga nell'ultimo trimestre, lavora con le aziende di assistenza clienti basata sull'IA Cresta e Sierra, e che gli agenti IA hanno eliminato più di 30 milioni di interazioni di assistenza quest'anno, riducendo i contatti di circa il 20%.
Cosa significa per te: se un colosso può spostare un quinto dei contatti con i clienti sull'IA, una piccola impresa può partire dalle sue dieci domande più frequenti. Scrivi le risposte una volta, mettile sul sito e in un assistente, e lascia una persona per i casi complicati. Il mio articolo sulle aziende che riassumono le persone sostituite dall'IA (in inglese) spiega cosa va storto quando tagli prima le persone.
Il primo satellite data center di Google è operativo
Google dice che il prototipo di Project Suncatcher, lanciato su un Falcon 9 di SpaceX il 1° ottobre, è ora operativo, e che il suo primo test è stato Gemma 4 che scriveva un haiku dall'orbita, secondo AI Weekly. Il satellite ha a bordo quattro TPU, ma può alimentarne solo una alla volta, per circa 20 minuti con un budget di 1 kW. NewsBytes spiega che sta verificando se i chip resistono a radiazioni e temperature estreme. Altri due satelliti con chip più recenti sono previsti per il 2027.
Cosa significa per te: niente da fare oggi. È un segnale di quanto le aziende di IA stiano cercando energia e potenza di calcolo, ed è per questo che prezzi e limiti d'uso dell'IA continuano a cambiare. Non costruire la tua attività sul prezzo attuale di un solo strumento.
L'autorità britannica indaga sui termini di Meta per gli editori
La Competition and Markets Authority del Regno Unito ha aperto il 30 ottobre un'indagine formale per capire se i nuovi termini commerciali di Meta, che le permetterebbero di usare i contenuti web degli editori britannici per i propri prodotti e funzioni di IA senza lasciare scelta, costituiscano un abuso di posizione dominante, secondo AI Weekly. Le modifiche di Meta, previste per il 20 novembre, sono state sospese.
Cosa significa per te: se fai pubblicità o hai una pagina aziendale su Facebook o Instagram, leggi i termini che accetti. Ho spiegato cosa comportano gli ultimi termini di Meta per le aziende in I nuovi termini di Meta ti fanno pagare gli errori della sua IA.
FAQ
Cos'è __usage_ai-training nel robots.txt?
È un token comune di robots.txt che chiede alle aziende di IA di non usare le tue pagine per addestrare i loro modelli. Si aggiunge come gruppo a sé, "User-Agent: __usage_ai-training" seguito da "Disallow: /" o da cartelle specifiche. Nasce da una bozza IETF scritta da Kevin Kelley di Anthropic a ottobre 2026.
Quali aziende di IA rispettano il nuovo token di opt-out?
OpenAI, Google, Microsoft e Anthropic. Anthropic ha iniziato ad applicarlo, OpenAI dice nei prossimi mesi, Microsoft dal 1° febbraio 2027 e Google nel 2027. Meta ha accolto bene l'idea, ma non si è impegnata a rispettarlo.
Bloccare l'addestramento dell'IA danneggia il posizionamento su Google?
No. Il token copre solo l'addestramento dell'IA. Google dice che Google-Extended non influisce sulla Ricerca Google, e Microsoft dice che le sue impostazioni di addestramento non cambiano la presenza su Bing. Non aggiungere però un "Disallow: /" generale sotto "User-agent: *", che blocca anche i motori di ricerca.
L'opt-out impedisce a ChatGPT o Copilot di citare il mio sito?
Da solo no. Copre l'addestramento, non la consultazione in tempo reale per rispondere alle domande. Microsoft ha una preferenza di grounding separata, impostata con un meta tag o un'intestazione HTTP, per le sue risposte IA, e avverte che escludersi riduce molto la visibilità su Bing e Copilot.
L'opt-out cancella i contenuti su cui l'IA si è già addestrata?
No. Vale solo da ora in poi. I contenuti già raccolti in dataset o modelli addestrati non vengono rimossi quando modifichi il robots.txt.
Una piccola impresa dovrebbe bloccare l'addestramento dell'IA?
Dipende da cosa vendi. Se vendi un servizio e vuoi essere consigliato, lasciare aperte le pagine commerciali pubbliche di solito aiuta. Se il prodotto sono i contenuti, come corsi, foto o articoli a pagamento, ha senso bloccare l'addestramento su quelle sezioni. Decidi pagina per pagina.
Fatti trovare dall'IA, alle tue condizioni.
Coaching individuale per imprenditori: decidiamo cosa deve sapere l'IA della tua attività, sistemiamo sito e schede, e configuriamo strumenti di IA che ti portano clienti.
Prenota la diagnosi da 49 € → IA per imprenditoriFonti: AI Weekly: OpenAI, Google, Microsoft, Anthropic back one AI opt-out token (30 ott 2026, riassunto di The Verge); Martin Cid Magazine: One robots.txt line will opt your site out of AI training (31 ott 2026); DEV Community, da SiliconANGLE (31 ott 2026); AI Weekly: AI news today (Comcast, Google Suncatcher, CMA e Meta, 30 ott 2026); GadgetReview (Comcast, 26 ott 2026); NewsBytes (Suncatcher). La regola pratica e i passaggi sono consigli miei.